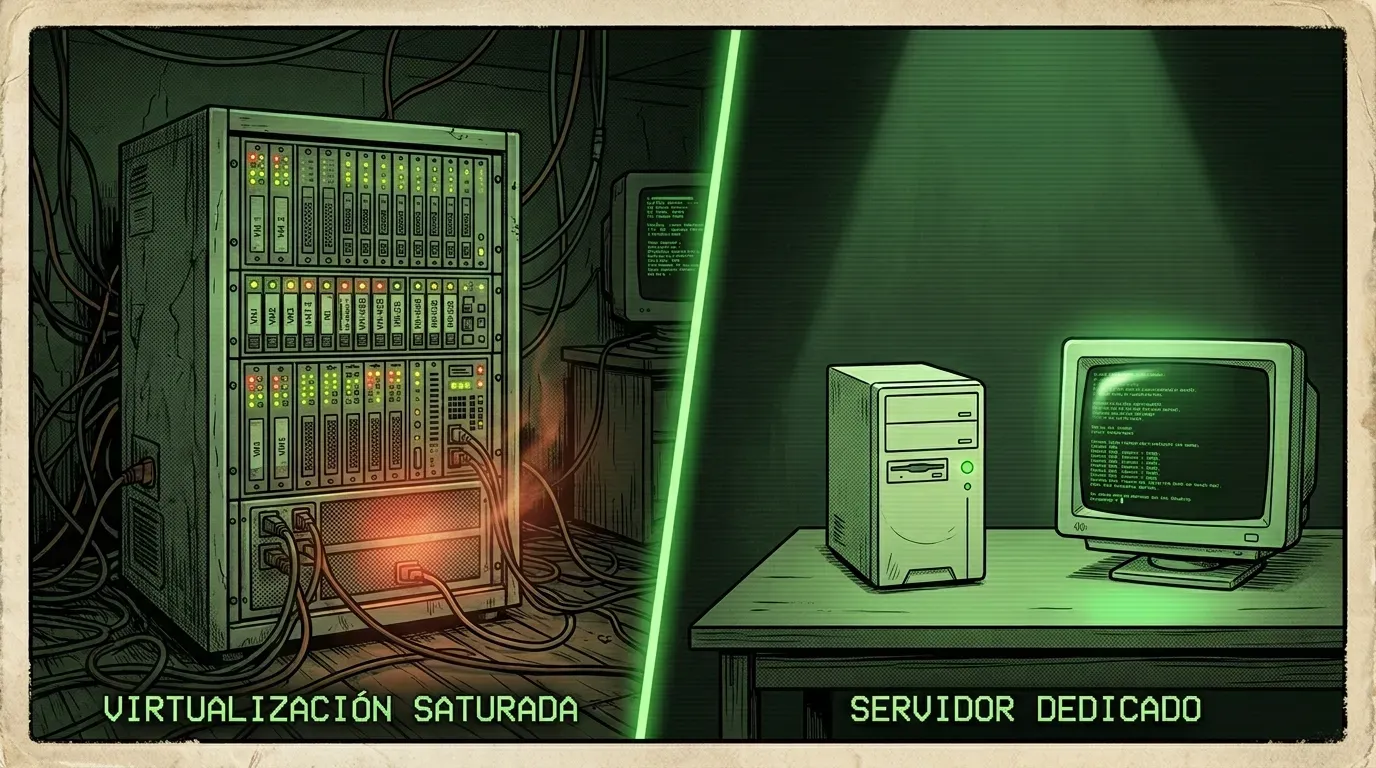
El problema no es nuevo: Proxmox Backup Server siempre ha corrido como VM en el mismo hardware físico que la carga de trabajo que se supone que respalda. Si el nodo sufre un fallo grave, el servidor de backups cae con él. Lo tenía asumido desde siempre en el BMAX — era la única máquina que tenía, así que no había alternativa real.
Lo que cambió fue la migración del nodo principal del homelab de ese BMAX B2Plus a un GMKtec G11. Con el BMAX ya liberado, miré cuánto sacaría vendiéndolo — y el precio de reventa sin su disco principal (reutilizado en un mirror ZFS del GMKtec) no compensaba. Mejor idea: reaprovecharlo como lo que llevaba tiempo echando en falta, un servidor PBS bare-metal dedicado — Debian + Proxmox Backup Server directamente, sin capa de virtualización encima — y resolver de paso ese punto único de fallo que hasta ahora tocaba asumir.
Punto de partida
- Instalación de PBS mediante la ISO oficial descargada del sitio web de Proxmox, grabada en un USB de arranque.
- El datastore real (
nas-backup) sigue viviendo en la NAS (OMV,192.168.1.131), vía NFS — el plan era apuntar el PBS nuevo a ese mismo NFS sin mover ni un byte - IP temporal
192.168.1.15durante la transición, IP final192.168.1.11(la que ocupaba la VM 103 de PBS) - El BMAX tuvo en su día una avería de su único puerto Ethernet — antes de comprometerlo a un rol crítico, tocaba comprobar que no era recurrente
Paso 1: prueba de estrés del puerto Ethernet
Antes de fiarme del BMAX para algo tan crítico como los backups, quería descartar que la avería histórica del puerto se repitiera bajo carga real, no solo con un ping.
# En el GMKtec (servidor):
iperf3 -s

# En el BMAX (cliente), 4 horas bidireccionales:
iperf3 -c 192.168.1.10 -t 14400 -i 10 --bidir 2>&1 | tee /root/stress-eth-bmax.log
Resultado tras las 4 horas completas: ~913-932 Mbits/sec sostenidos (saturando el gigabit del enlace), solo 260 retransmisiones sobre 1.49TB transferidos, sin ninguna caída de enlace detectada. El puerto quedó confirmado sano — la avería histórica no se repitió bajo carga sostenida.
Paso 3: reutilizar el datastore sin mover datos
El objetivo era que el PBS nuevo sirviera el mismo NFS que ya usaba la VM 103, sin sincronizar ni copiar nada. El camino no fue tan directo como esperaba.
Primer obstáculo — ACL de NFS por IP. El export /pbs-backup en la NAS solo tenía permiso para las IPs .11 y .12, no para la .15 temporal del BMAX. Hubo que añadir la ACL para .15 en OMV antes de que el montaje apuntara al recurso real.
Segundo obstáculo — propietario del punto raíz. Con el NFS ya correcto, datastore create --reuse-datastore true fallaba con unable to open existing chunk store path - permissions or owner not correct. El contenido interno (.chunks/, ct/, vm/) tenía el propietario backup:backup (UID/GID 34:34) correcto, pero el propio directorio raíz del montaje tenía grupo 100 en vez de 34 — un detalle heredado de cómo se creó originalmente el share en la NAS, que nunca se había validado porque la instalación original de la VM 103 no pasó por esta comprobación de "reuse".
chown backup:backup /mnt/pbs-nas
proxmox-backup-manager datastore create nas-backup /mnt/pbs-nas --reuse-datastore true --comment "NAS OMV via NFS"
Tercer obstáculo — ACL raíz de PBS nunca inicializada. A pesar de instalar PBS mediante la ISO oficial (grabada en un USB de arranque, no una instalación manual), el usuario root@pam no tenía ninguna entrada en la ACL — algo que en teoría el instalador oficial deja resuelto de fábrica. Los comandos acl update se ejecutaban sin error mostrado pero no escribían nada en /etc/proxmox-backup/acl.cfg. Solución: escribir la línea a mano.
cat >> /etc/proxmox-backup/acl.cfg << 'EOF'
acl:1:/:root@pam:Admin
EOF
systemctl restart proxmox-backup-proxy
Lección: Si vas a montar PBS así, verifica la ACL raíz explícitamente antes de dar la instalación por buena.
Paso 4: replicar credenciales para los jobs de vzdump
Los jobs de vzdump del GMKtec usan un usuario dedicado (backup@pbs, con rol DatastoreAdmin sobre /datastore), no root@pam. Lo repliqué exactamente igual en el BMAX para que ningún job necesitara cambiar de credencial.
proxmox-backup-manager user create backup@pbs --email admin@admin.net
proxmox-backup-manager acl update /datastore DatastoreAdmin --auth-id backup@pbs
Detalle curioso: proxmox-backup-manager user update <userid> --password está deprecado — el propio CLI lo indica ("this parameter is ignored, please use PUT /access/password"). El cambio de contraseña real solo se puede hacer desde la interfaz web (o llamando directamente a la API), no desde user create/user update.
Paso 5: restauración de prueba real
Listar backups no prueba nada por sí solo — solo confirma que los índices son legibles. La prueba real es reconstruir un sistema de archivos completo a partir de los chunks.
# En el GMKtec, storage temporal apuntando al PBS nuevo:
pvesm add pbs pbs-bmax-test --server 192.168.1.15 --datastore nas-backup \
  --username backup@pbs --password '...' --fingerprint <fingerprint-bmax>

pct restore 999 pbs-bmax-test:backup/ct/139/2026-09-11T17:25:02Z --storage local-zfs
pct start 999
Resultado: restore completo en 1m34s (2.7GB procesados, 94.4% reutilizado incrementalmente), CT arrancando correctamente. Confirmación de extremo a extremo: autenticación, red, lectura de chunks, e integridad del filesystem restaurado.
Paso 6: repuntar los jobs de producción
Los 4 jobs (Criticos, Importantes, Normal, PBS) apuntaban todos al mismo storage pbs-nas, lo que simplificó la decisión: en vez de crear un storage paralelo y editar cada job, edité pbs-nas in-place.
# server es un parámetro "fijo" en pvesm set — no se puede editar así:
pvesm set pbs-nas --server 192.168.1.15
# Error: can't change value of fixed parameter 'server'

# Hay que editar el fichero directamente:
nano /etc/pve/storage.cfg
Y ojo con un detalle tonto pero real: al editar a mano, es fácil dejar dos líneas fingerprint en el mismo bloque (la antigua sin borrar y la nueva añadida debajo) — Proxmox VE lee la primera que encuentra, así que el storage seguía intentando verificar contra el certificado equivocado hasta que borré la línea vieja.
Validación con un backup real e incremental contra el PBS nuevo: éxito, reutilizando el 94.4% de chunks ya existentes gracias a la deduplicación compartida.
Paso 7: decomisar la VM 103
Antes de apagarla, desactivé el job pbs-gmktec (el que respaldaba la propia VM de PBS), ya que quedaría huérfano apuntando a un VMID inexistente.
qm shutdown 103
qm status 103   # stopped
Decisión: dejarla parada varios días como red de seguridad silenciosa antes del qm destroy definitivo, en vez de borrarla de inmediato.
Un incidente por el camino: OOM en Home Assistant
Durante el paso 6, con la prueba de iperf3 aún corriendo en paralelo a un vzdump manual, el kernel del GMKtec disparó el OOM killer y mató el proceso KVM de Home Assistant. Causa raíz: el nodo solo tiene 11GB utilizables de 16GB físicos (reserva de iGPU en BIOS pendiente de ajustar), y apilar red + I/O de backup + carga normal sobre ese margen ya ajustado fue demasiado.
El GMKtec no tenía swap configurado — a diferencia del BMAX anterior, que "aguantaba" el mismo tipo de presión de memoria paginando a un swap constante de varios GB (síntoma de estar al límite, pero sin caídas visibles). Mitigación aplicada: un zvol de swap de 4GB como red de seguridad.
zfs create -V 4G -b 16384 rpool/swap
mkswap /dev/zvol/rpool/swap
swapon /dev/zvol/rpool/swap
echo '/dev/zvol/rpool/swap none swap discard 0 0' >> /etc/fstab
zfs set sync=always rpool/swap
zfs set primarycache=metadata rpool/swap
zfs set com.sun:auto-snapshot=false rpool/swap
Nota para ZFS: un fichero de swap normal (fallocate/dd + mkswap) no funciona sobre datasets ZFS — falla con "appears to have holes". Hace falta un zvol dedicado.
El swap es un parche, no la solución de fondo: sigue pendiente entrar en la BIOS del GMKtec y reducir la reserva de memoria de la iGPU para recuperar los GB bloqueados sin usar.
Paso 8: la IP definitiva
Con la VM 103 confirmada parada, cambié la IP del BMAX de .15 a .11:
# /etc/network/interfaces
auto nic0
iface nic0 inet static
        address 192.168.1.11/24
        gateway 192.168.1.1
ifdown nic0 && ifup nic0Tras el cambio, el montaje NFS quedó en estado "stale" — el filehandle abierto estaba ligado a la sesión con la IP antigua, así que hubo que remontarlo (parando antes proxmox-backup-proxy, que lo tenía en uso):
systemctl stop proxmox-backup-proxy
umount /mnt/pbs-nas
mount -a
systemctl start proxmox-backup-proxy
Y en el GMKtec, actualizar el storage a la IP final (de nuevo editando storage.cfg a mano, ya que server sigue siendo un parámetro fijo):
# server 192.168.1.15 → server 192.168.1.11Validación final con otro backup real: pbs-nas activo, 1.6TB/402GB, todo funcionando.
Extra: WiFi de emergencia
El BMAX es precisamente la máquina con historial de avería en su único puerto Ethernet — así que replicé el mismo patrón de red de seguridad que ya usamos en el GMKtec: una interfaz WiFi configurada pero sin arranque automático, lista para activar a mano si el puerto vuelve a fallar.
# /etc/wpa_supplicant/wpa_supplicant-wlo2.conf
ctrl_interface=/var/run/wpa_supplicant
update_config=1

network={
        ssid="..."
        psk="..."
}
# /etc/network/interfaces (sin "auto", para que no arranque sola)
iface wlo2 inet dhcp
wpa-conf /etc/wpa_supplicant/wpa_supplicant-wlo2.confValidación real: bajé nic0 a propósito para forzar el escenario de fallo real, y confirmé asociación WiFi, DHCP, ruta por defecto y salida a internet, todo funcionando con la Ethernet caída. Un detalle a tener en cuenta: el lease DHCP no se reaplicó solo al caer la interfaz principal — hizo falta forzar dhclient -r + dhclient a mano para que la ruta por defecto se instalara. Si algún día toca usar esto de verdad en una emergencia, ese es el paso extra a recordar.
Un hallazgo inesperado: notificaciones perdidas en la migración anterior
Repasando el plan original, quería confirmar que las notificaciones de Telegram de los backups seguirían funcionando tras todo esto. Resultó que nunca dependieron de PBS: vienen de un hook script de vzdump (/usr/local/bin/backup-notify.sh) que vive en el propio host de Proxmox VE, no en la VM de PBS.
El hallazgo real fue otro: ese script se había perdido en la migración BMAX→GMKtec de hace unas semanas. Tiene sentido — un fichero suelto en /usr/local/bin del host no lo cubre ningún backup de vzdump (que solo respalda CT/VM), así que sobrevivió al BMAX pero nunca llegó al GMKtec. Lo recreé con el contenido documentado en un post anterior, y recuperé el token del bot y el chat ID de otro script de la misma familia (proxmox-node-backup.sh, encontrado en una copia de seguridad de nodo) que compartía el mismo bot de Telegram.
Lección repetida: cualquier fichero de configuración que viva en el host y no en un CT/VM (scripts, hooks, crons sueltos) necesita su propio backup explícito — vzdump nunca lo va a cubrir por definición.
Bonus: liberando la memoria atrapada en la iGPU
Uno de los pendientes que quedó anotado tras el susto del OOM de Home Assistant era entrar en la BIOS del GMKtec y reducir la reserva de memoria para la GPU integrada. Ya lo he hecho: estaba reservando 4GB fijos para la iGPU (algo típico por defecto en muchas BIOS de mini PC, pensado para equipos que sí usan esa gráfica para algo exigente), y lo he bajado a 256MB.
Para un mini PC que solo hace de nodo Proxmox — sin salida de vídeo en uso, sin transcodificación por GPU, sin ningún CT/VM usando aceleración gráfica activamente (Jellyfin tiene el dispositivo /dev/dri mapeado, pero la transcodificación por hardware está desactivada) — 4GB reservados de forma permanente e inutilizable eran pura memoria tirada a la basura. 256MB es más que suficiente para lo que la propia BIOS/firmware necesita mostrar en una pantalla si hiciera falta conectarla en algún momento.
Resultado: recuperados esos ~3.7GB extra de RAM utilizable, sin tocar nada de software — solo un ajuste de firmware que llevaba semanas pendiente. Con esto, el swap de emergencia que monté aquel día pasa a ser eso, un colchón de verdad para picos puntuales, y no una necesidad estructural por ir corto de memoria.
Resultado final
- Puerto Ethernet del BMAX validado bajo 4h de carga sostenida
- Datastore de 1.6TB migrado a bare-metal sin mover un solo byte
- Restauración real probada de extremo a extremo antes de tocar producción
- Los 4 jobs de backup funcionando contra el nuevo servidor, con deduplicación intacta
- VM 103 decomisionada, liberando 2GB de RAM en el GMKtec
- Punto único de fallo eliminado: los backups ya no dependen del mismo hardware que la carga de trabajo
- WiFi de emergencia como red de seguridad adicional
- Notificaciones de Telegram recuperadas de un descuido de la migración anterior
Pendiente para otro día: limpiar la ACL NFS de la NAS (retirar las IPs temporales usadas durante la migración), decidir sobre el sync offsite hacia el Storage Box de Hetzner, ajustar la reserva de iGPU en BIOS del GMKtec, y el qm destroy definitivo de la VM 103 tras el periodo de observación.