Con los 23 servicios ya migrados y verificados (contado en la primera y segunda parte de esta serie), quedaban tres cosas por cerrar: completar el mirror ZFS que llevaba planeado desde el principio, un susto de arranque que apareció de la nada, y montar un sistema real de aviso para el propio storage.
El checklist antes de dar nada por definitivo
Antes de tocar el disco, repasé que todo lo migrado sobreviviera a un reinicio completo del nodo, no solo al arranque en caliente del propio proceso de restauración: cada servicio crítico probado dos veces, el certificado wildcard reimportado en el nuevo nodo, los backups programados apuntando ya al GMKtec, la regla de Pi-hole que evita que responda DHCP al deco de Movistar todavía presente tras la restauración, y una prueba real de acceso remoto desde fuera de casa con datos móviles. Nada revolucionario, pero es el tipo de repaso que evita sorpresas después.
Completar el mirror: más peleas de las esperadas con un simple borrado
El plan de siempre había sido reutilizar el Crucial P3 del BMAX, ya sin uso, como segundo miembro de un mirror ZFS en el segundo slot M.2 del GMKtec —sin comprar hardware nuevo. Antes de montarlo, tocaba borrarlo de forma segura, dado que venía de un sistema con mucha escritura de swap acumulada. Lo que parecía el paso más trivial de todo el proceso resultó ser el que más vueltas dio.
nvme format --ses=1, el secure erase a nivel de controlador, no funciona cuando el disco va detrás de un adaptador USB —el chip puente no traduce los comandos NVMe nativos. blkdiscard -f tampoco funcionó, con un escueto "Operation not supported": el adaptador USB usado (un UGREEN que enumera por defecto como UASP) tampoco pasaba el TRIM/UNMAP al disco. Lo que sí funcionó, sin depender de qué supiera traducir el puente, fue el método más universal de todos:
sudo dd if=/dev/zero of=/dev/sdX bs=4M status=progress500GB por USB 3.x, unos 20 minutos a 414MB/s de media.
Por el camino apareció un segundo problema, más confuso todavía: al intentar montar el disco desde otro equipo para rescatar un fichero, mount fallaba con "unable to read superblock" y "Buffer I/O error", pese a que el SMART confirmaba el disco perfectamente sano. La causa era, otra vez, el driver UASP —con fallos de compatibilidad conocidos en según qué adaptadores baratos combinados con discos NVMe de bloque físico 4096 y lógico 512. La solución fue forzar el driver clásico usb-storage en vez de uas: desconectar el disco, descargar el módulo (sudo modprobe -r uas, tras confirmar que su contador de uso estaba a cero), y reconectarlo —el kernel recurre entonces a usb-storage automáticamente, y el disco se lee sin ningún problema.
Con el disco ya limpio, comprobé su salud de nuevo con SMART: overall-health: PASSED, cero errores de integridad, el mismo 20% de desgaste que antes de escribir los 500GB completos —una escritura entera del disco es, de paso, una buena prueba de estrés antes de confiarle un papel de redundancia.
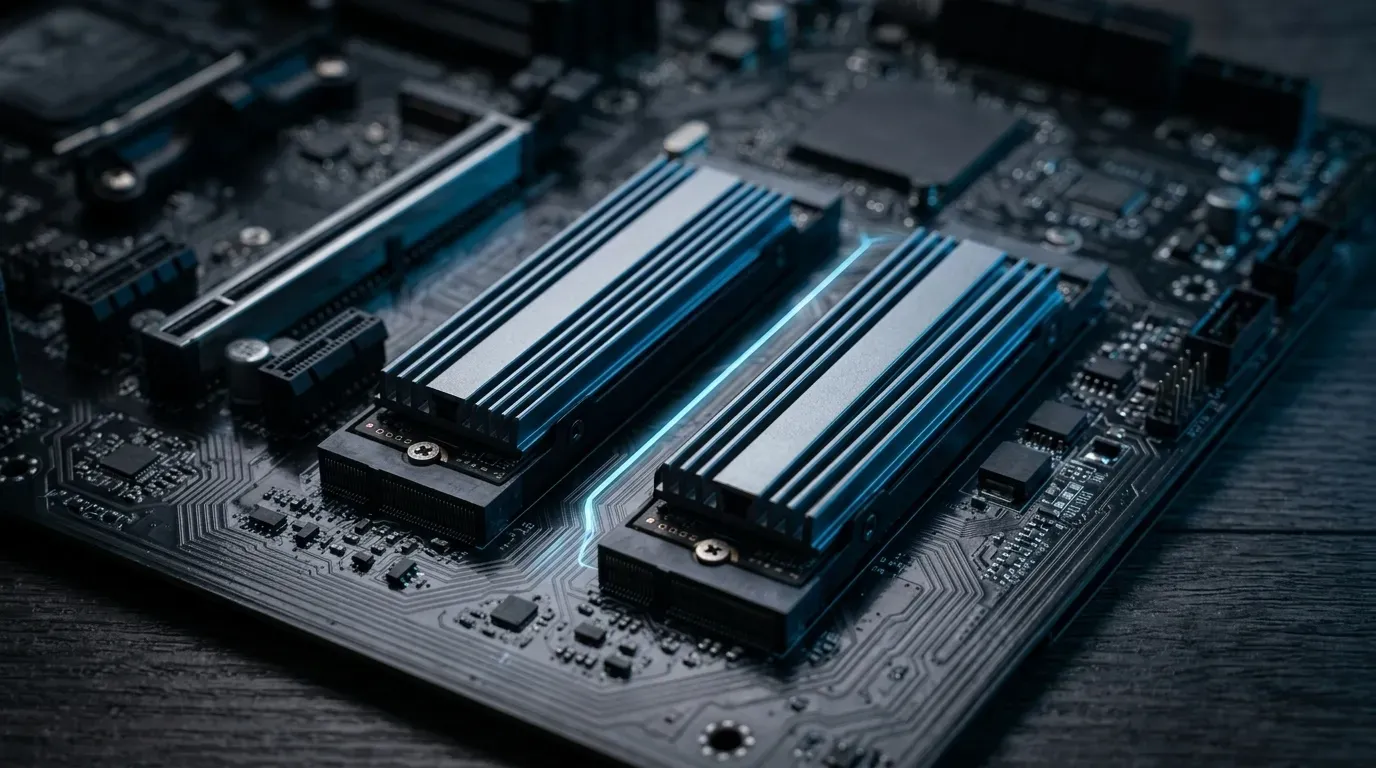
Lo monté en el segundo slot con un disipador GLOTRENDS de perfil bajo (el mismo estilo que ya traía de serie el primer disco: aletas de aluminio, clips de silicona incluidos), y una vez el sistema lo reconoció:
zpool attach rpool <by-id-970-evo-plus> <by-id-crucial-p3>El resilver terminó en menos de dos minutos —solo 89.5GB de datos reales, no los 500GB completos, porque ZFS solo resincroniza bloques con contenido— sin ningún error. El GMKtec quedó con redundancia real: si cualquiera de los dos discos falla, el sistema sigue funcionando sin interrupción.
El susto que no era lo que parecía
Con el mirror completo, un reinicio del equipo (para entrar a la BIOS a ajustar algo que contamos justo después) dejó las dos interfaces de red en DOWN, sin subir solas. La primera sospecha, razonable pero equivocada, apuntaba al driver r8125 —el mismo que había dado guerra durante la instalación— negociando el enlace más lento de lo normal en un arranque frío. Un systemctl restart networking manual arreglaba la red al instante cada vez, lo cual parecía confirmar la teoría. Se repitió dos veces más en arranques sucesivos, cada vez con el mismo parche funcionando, y cada vez sin entender realmente qué pasaba.
La pista real apareció al mirar los logs del arranque fallido, algo que se puede hacer después sin haber estado delante en el momento exacto, gracias al journal persistente:
journalctl --list-boots
journalctl -b -1 -u ifupdown2-pre.service --no-pager
El log no mentía:
udevadm[539]: Timed out while waiting for udev queue to empty.
systemd-udevd[536]: sda: Worker [573] processing SEQNUM=2945 is taking a long time
(udev-worker)[573]: sda: Spawned process '/bin/systemctl start media-mount@MEDIA04.service' [645] is taking longer than 59s to complete.
No era el driver de red en absoluto. Era la regla udev de los discos MediaCenter —la misma que había hecho falta replicar para que Jellyfin encontrara su biblioteca durante la migración— la que estaba causando el problema. Un disco USB externo (MEDIA04) tardó más de 90 segundos en montar durante ese arranque concreto, y el servicio que lo gestiona no tenía ningún timeout configurado. Sin límite de tiempo, ese montaje colgado bloqueó la cola entera de eventos de udev, ifupdown2-pre.service (que espera a que esa cola esté vacía antes de continuar) agotó su propio margen, networking.service falló en cascada por dependencia, y con él, el arranque automático de los 22 contenedores y la propia VM.
La corrección real no tuvo nada que ver con la red ni con el driver que llevaba días sospechando:
mkdir -p /etc/systemd/system/media-mount@.service.d
cat > /etc/systemd/system/media-mount@.service.d/timeout.conf << 'EOF'
[Service]
TimeoutStartSec=20
EOF
systemctl daemon-reload
Con esto, si un disco de la colección MediaCenter no responde en 20 segundos, el servicio de montaje falla limpio en vez de bloquear todo lo demás —el disco en cuestión simplemente no queda montado esa vez, pero la red y el resto de servicios arrancan con normalidad. La lección quedó clara: cualquier servicio systemd que dependa de hardware externo poco fiable necesita un timeout explícito, porque sin él puede arrastrar consigo servicios que no tienen ninguna relación aparente con el hardware que falla.
La memoria que se escondía en la BIOS
Con los 22 servicios corriendo, free -h mostraba solo 11GB de RAM total, pese a que el GMKtec lleva dos módulos DDR4 de 8GB —16GB físicos, confirmados con dmidecode. Los cinco gigas que faltaban no eran un fallo de detección: era memoria reservada en la BIOS para la GPU integrada, algo habitual en mini PCs con gráfica Radeon, y que en un servidor sin cabeza como este no aporta absolutamente nada.
Bajar esa reserva al mínimo disponible (256MB, en vez del "Auto" que tiende a reservar de más) devolvió el sistema a 15GB reales, sin tocar ninguna configuración de los contenedores. Fue un ajuste que llegaba en buen momento: con Home Assistant reservando 4GB y PBS otros 2GB de forma fija en vez de dinámica, el margen libre había llegado a rozar el 91% de uso en algún momento del proceso.
Enterarse de verdad si un disco falla
El mirror por sí solo da redundancia, pero no avisa de nada —ZFS no manda notificaciones activas salvo que se las configures. Monté tres capas, cada una cubriendo el punto ciego de la anterior.
La primera, ZED (el propio demonio de eventos de ZFS, que ya viene instalado en Proxmox), reconfigurado para avisar por Telegram en vez de por un email a root que nadie mira, reutilizando las mismas credenciales que ya usaba para las notificaciones del SAI:
cat > /etc/zfs/zed.d/all-telegram.sh << 'EOF'
#!/bin/bash
source /etc/jaws.conf

case "$ZEVENT_SUBCLASS" in
    statechange|scrub_finish|resilver_finish|checksum|io)
        POOL_STATUS=$(zpool status "$ZEVENT_POOL" | grep -E "^\s*state:")
        MESSAGE="🔴 ZFS evento: ${ZEVENT_SUBCLASS} en pool ${ZEVENT_POOL}%0A${POOL_STATUS}"
        curl -s -X POST "https://api.telegram.org/bot${TELEGRAM_TOKEN}/sendMessage" \
            -d chat_id="${TELEGRAM_CHAT_ID}" \
            -d text="${MESSAGE}" \
            -d parse_mode="HTML" > /dev/null
        ;;
esac
EOF
chmod +x /etc/zfs/zed.d/all-telegram.sh
systemctl restart zed
Un zpool scrub rpool sirvió de prueba real sin tener que esperar a que fallara un disco de verdad —el evento scrub_finish al terminar confirmó que el mensaje llegaba.
La segunda capa, un chequeo diario por cron, como red de seguridad por si el aviso inmediato de ZED no llegara a dispararse por algún motivo:
echo '0 8 * * * /usr/local/bin/zfs-health-check.sh' >> /var/spool/cron/crontabs/rootY la tercera, un scrub mensual, para sacar a la luz corrupción silenciosa que un uso normal nunca llegaría a tocar:
echo '0 3 1 * * zpool scrub rpool' >> /var/spool/cron/crontabs/rootCon las tres capas en marcha, si algún día uno de los dos discos falla de verdad: el pool sigue funcionando sin interrupción, zpool status pasa de ONLINE a DEGRADED, ZED dispara un aviso inmediato a Telegram, y como último resorte, el chequeo diario detectaría el problema como muy tarde a la mañana siguiente aunque el aviso inmediato fallara por lo que sea.
Cierre
Veintitrés servicios migrados, un mirror ZFS completado con hardware reciclado, dos causas raíz encontradas donde la primera sospecha apuntaba siempre a otro sitio, y un sistema de monitorización que antes no existía. El BMAX, mientras tanto, no se jubiló del todo —quedó pendiente de una segunda vida como servidor de backups dedicado, pero esa es ya otra historia.